Nextflow安装和入门使用
Nextflow install and Setting
“Dataflow variables are spectacularly expressive in concurrent programming”
Nextflow的核心思想: 将并发编程中的“同步”与“数据传递”合二为一,通过“赋值即同步”的语义,从根本上消除了传统共享内存并发中的竞态条件和显式锁机制
Nextflow 是一个用于构建可扩展、可移植且可复现工作流的流程管理系统。它采用数据流编程模型,通过让你专注于数据流转与计算过程,简化了并行及分布式流水线的编写。Nextflow 能够将工作流部署到多种执行平台上,包括本地机器、高性能计算(HPC)调度器以及云端环境。此外,Nextflow 支持多种计算环境、软件容器运行时及包管理器,使工作流能够在可复现且隔离的环境中运行
1. 背景
Nextflow 语言的设计灵感源自 Unix 哲学,即通过将众多简单的命令行工具组合起来,构建出功能强大的工作流。同理,Nextflow 脚本也是由许多简单的“进程”组合成流水线。每个进程可以使用任何受支持的编程语言来执行指定的工具或脚本,你只需定义好进程的输入和输出,Nextflow 就会自动为你协调各个任务的执行
Unix philosophy:Unix 哲学,指“让每个程序只做好一件事”的设计思想,强调通过组合简单工具来解决复杂问题
1.1 诞生发展历史
2013年3月,Nextflow 在 GitHub 首次发布,由西班牙巴塞罗那基因组调控中心(CRG)的工程师 Paolo Di Tommaso 主导开发。其诞生直接受 Docker 容器技术启发——Di Tommaso 在观看 Docker 创始人 Solomon Hykes 的演讲后,认定容器是解决科学工作流”可复现性”问题的关键,因此从设计之初就将 Docker 作为”一等公民”,核心目标是让数据密集型工作流能在任何基础设施上运行。
技术底座与早期版本
语言与架构:基于 JVM 运行,采用 Groovy 语言编写,核心设计遵循 Unix 哲学与数据流编程模型,通过”进程(process)“和”通道(channel)“的组合实现并行与分布式计算
执行平台支持:早期即支持本地、HPC 调度器(如 Slurm)、云平台(AWS、GCP)等多种执行环境,奠定了”一次编写,随处运行”的基础
关键版本迭代
2021-2022年:DSL2 成为默认语法:DSL2(领域特定语言第二版)是 Nextflow 的重大里程碑,它将工作流拆解为可复用的”模块(modules)“和”子流程(subworkflows)“,类似”乐高积木”式的模块化设计。2022年4月发布的 22.04.0 稳定版正式将 DSL2 设为默认语法,同时要求 Java 11 及以上版本,引入了现代 Java 运行时能力
2023年:日历化版本管理:采用”年.月.补丁”的日历版本格式(如 23.10.1),每年4月和10月发布稳定版,每月发布 edge 版(含实验性功能)
2024-2025年:语言服务器与插件生态:2024.10 版本引入语言服务器,2025.04 版本集成语法解析器,2025.10 版本新增静态类型、工作流输入输出声明、nextflow auth/nextflow launch 新命令,并推出官方插件注册中心(Plugin Registry),简化插件发现与管理
1.2 社区生态
2018年,nf-core 社区成立,旨在创建和维护一个由社区共同策划的高质量生物信息学分析流程集合。其核心贡献包括
标准化流程:截至2025年2月,已发布124个标准化流程,涵盖基因组学、转录组学、质谱、显微成像等领域,甚至扩展到天体物理学、地球科学等非生物领域
模块库:基于 DSL2 的模块化设计,nf-core/modules 积累了超过1400个模块和80个子流程,研究者可直接调用这些经过社区验证的标准化组件
DSL2(Domain-Specific Language 2)是 Nextflow 的领域特定语言第二版,引入了模块化工作流定义范式,将流程逻辑、执行配置、输入输出契约完全解耦
模块(module):是 DSL2 的最小复用单元,对应一个独立的计算任务, 每个模块都封装了完整的输入输出定义、执行脚本、资源约束(CPU/内存)、容器环境声明,甚至可以关联独立的测试用例和元数据说明
子流程(subworkflow):是多个模块的有序编排组合,对应一个完整的功能片段(比如“原始测序数据质控+接头修剪”的完整预处理流程),可以直接被其他流程调用,避免重复编写相同的步骤组合
工作流(workflow):是最终的分析流水线,通过调用模块或子流程,配合 Channel 数据流机制,完成从原始数据输入到最终结果输出的全流程调度
2. 核心模块
2.1 通道
核心是:process,workflow,channel
| 英文 | 推荐译法 | 说明 |
|---|---|---|
| Processes | 进程 | Nextflow 中的基本计算单元,每个进程封装一个独立的计算步骤(如质控、比对等),彼此隔离、独立执行。 |
| Dataflow | 数据流 / 数据流转 | 指数据在进程之间流动的方式。Nextflow 采用数据流编程模型,进程之间通过异步的通道(Channel)传递数据,数据到达即触发下游进程执行。 |
一个进程可以定义一个或多个输入和输出。数据通过异步的数据流结构在进程之间流动,这些结构被称为通道(Channel)和值(Value)。这些进程之间的数据依赖关系隐式地决定了执行流程
核心理解是在通道上:通道相当于一辆车,放着等待处理的数据
Channels(通道):Nextflow 中用于在进程间传递数据的核心异步数据结构,类似“数据管道”,支持队列通道(Queue Channel)和值通道(Value Channel)两种类型
核心异步数据结构指的是用于在进程(Process)之间传递数据、实现数据流编程模型的两种结构:通道(Channel)和值(Value)
| 特性 | 队列通道(Queue Channel) | 值通道(Value Channel) |
|---|---|---|
| 数据项数量 | 多个 | 单个 |
| 是否可重复读取 | 否(读取即消耗) | 是(无限次读取) |
| 典型用途 | 传递多个样本/文件 | 传递参考文件/配置参数 |
| 创建方式 | Channel.of()、Channel.fromPath()、进程输出 |
Channel.value()、隐式包装、聚合操作符 |
队列通道 就像一条传送带:物品从一端放上去,另一端的人取走一个就少一个,取完即止
值通道 就像一块公告板:上面贴着一张通知,所有人都可以反复查看,内容不会消失.
// 1. 工厂方法创建通道,装入3个样本名
samples_ch = Channel.of('sample1', 'sample2', 'sample3')

// 2. 定义进程,从通道取数据
process fastqc {
    input:
    val sample from samples_ch    // 从通道取数据
    output:
    path "${sample}_fastqc.html"  // 输出放入新通道
    script:
    """
    fastqc ${sample}.fastq
    """
}
唯一需要手动创建通道的场景:数据从”外部世界”进入 Nextflow 流水线的那一刻,一旦数据已经进入流水线,后续所有通道的创建都是自动的,你只需要”连接”它们。
| 数据源 | 工厂方法 | 示例 |
|---|---|---|
| 单个/多个文件路径 | Channel.fromPath() |
Channel.fromPath('/data/*.fa') |
| 配对文件(如双端测序) | Channel.fromFilePairs() |
Channel.fromFilePairs('/data/*_{1,2}.fq') |
| 内存中的列表/值 | Channel.of() |
Channel.of(1, 2, 3) |
| 单个值(不消耗) | Channel.value() |
Channel.value(params.db) |
| NCBI SRA 数据 | Channel.fromSRA() |
Channel.fromSRA('SRR123456') |
| 空通道 | Channel.empty() |
Channel.empty() |
| 监控文件夹新文件 | Channel.watchPath() |
Channel.watchPath('/data/*.fa') |
通道创建的规则就一条:数据从”流水线外部”进入时,你手动创建;数据在”流水线内部”流转时,Nextflow 自动创建。你只需要关心”数据从哪来、要到哪去”,中间的通道 Nextflow 会帮你打理好。
2.2 Process 进程
这段代码是一个非常经典的 Nextflow 入门示例,展示了一个完整的 BLAST 搜索 → 提取序列 的两步流水线
| 部分 | 作用 |
|---|---|
params |
定义脚本参数(全局变量),支持命令行覆盖 |
process |
定义计算任务(流水线中的每个”步骤”) |
workflow |
定义数据流,将多个 process 串联起来 |
// Script parameters
params.query = "/some/data/sample.fa"
params.db = "/some/path/pdb"

// Define the blast_search process
process blast_search {
  input:
  path query
  path db

  output:
  path "top_hits.txt"

  script:
  """
  blastp -db $db -query $query -outfmt 6 > blast_result
  cat blast_result | head -n 10 | cut -f 2 > top_hits.txt
  """
}

// Define the extract_top_hits process
process extract_top_hits {
  input:
  path top_hits
  path db

  output:
  path "sequences.txt"

  script:
  """
  blastdbcmd -db $db -entry_batch $top_hits > sequences.txt
  """
}

// Define the workflow
workflow {
  def query_ch = channel.fromPath(params.query)
  blast_search(query_ch, params.db)
  extract_top_hits(blast_search.out, params.db).view()
}- 脚本参数(params)
params.query = "/some/data/sample.fa"
params.db = "/some/path/pdb"params是 Nextflow 内置的全局变量对象,用于定义可在命令行覆盖的参数- 运行时可以用
--query /path/to/file.fa覆盖默认值 - 在 workflow 块和 process 的 script 中都可以直接引用
params.query
2.第一个 process:blast_search
process blast_search {
  input:
  path query
  path db

  output:
  path "top_hits.txt"

  script:
  """
  blastp -db $db -query $query -outfmt 6 > blast_result
  cat blast_result | head -n 10 | cut -f 2 > top_hits.txt
  """
}input块 —— 声明输入
- 声明了两个输入:
query(查询序列文件)和db(BLAST 数据库路径) path是输入限定符(qualifier),告诉 Nextflow 这两个输入是文件/目录路径,Nextflow 会自动处理文件的暂存(staging)——把文件拷贝到任务的 work/ 目录中
path 限定符(qualifier)是 Nextflow 中专门用于声明”文件/目录路径类型数据”的输入或输出限定符,它的核心作用是告诉 Nextflow:“这个变量不是一个普通字符串,而是一个需要特殊处理的文件路径”,从而触发 Nextflow 的文件暂存(staging)机制
- 在 workflow 块中调用
blast_search(query_ch, params.db)时,query_ch是一个通道,params.db 是一个简单字符串。Nextflow 会自动把 params.db 包装成值通道,所以两个输入都能正确传递
output块–声明输出
- 声明该进程会生成一个名为 top_hits.txt 的文件
- Nextflow 会在进程执行结束后,自动把 top_hits.txt 放入一个新的队列通道中,供下游进程消费
- 在 workflow 中可以通过 blast_search.out 来引用这个输出通道
script块–执行命令
- 使用三引号
"""包裹多行 Bash 脚本 $db和$query是 Groovy 变量插值,Nextflow 会把 input 中声明的变量值替换进来
Process的完整语法模板
process <名称> {
  [directives]    // 指令(可选):如 cpus, memory, container, publishDir 等
  input:          // 输入声明(可选)
    <限定符> <变量名>
  output:         // 输出声明(可选)
    <限定符> <文件名>
  when:           // 条件判断(可选)
    <布尔表达式>
  script:         // 执行脚本(必需,或用 exec 块写 Groovy 代码)
    """
    <Bash 命令>
    """
}| 限定符 | 含义 |
|---|---|
val |
传递一个简单值(字符串、数字等) |
path |
传递文件或目录路径 |
tuple |
传递多个值的组合(如样本名+文件对) |
each |
对列表中的每个元素分别执行一次 |
- Process 是并行执行的:如果输入通道中有 N 个数据项,process 会自动触发 N 次独立的任务执行,天然实现并行
- 每个 process 在独立的 work 目录中运行:Nextflow 会为每个任务创建一个唯一的 work/
/ 目录,输入文件被软链接或拷贝进去,输出文件从该目录收集。这保证了任务之间的隔离性 - 断点续传(-resume):如果流程中断,加上 -resume 参数重新运行,Nextflow 会跳过已成功完成的任务,从断点继续执行,大幅节省时间
Directives(指令)是写在 process 内部、位于 input 之前的“任务配置项”,用于定义该任务的运行环境、资源需求、输出位置及容错策略
process my_task {
    // ✅ 指令区:必须放在最上面
    cpus 4
    memory '16 GB'
    container 'biocontainers/samtools:1.3.1'
    publishDir params.outdir

    // 其他声明块
    input:
    path reads
    ...
}
2.3 workflow 块 —— 串联流程
workflow {
  def query_ch = channel.fromPath(params.query)
  blast_search(query_ch, params.db)
  extract_top_hits(blast_search.out, params.db).view()
}
创建输入通道
def query_ch = channel.fromPath(params.query)是通道工厂方法,根据文件路径创建一个队列通道,通道中装着匹配的文件路径对象调用第一个进程,像调用函数一样调用 process,按顺序传入输入通道,
query_ch是队列通道,params.db是简单值(被隐式包装为值通道)
2.4 执行器
Process(进程):定义”做什么”——要执行什么命令或脚本(比如 bwa mem、samtools sort)
Executor(执行器):定义”怎么跑、跑在哪”——这个脚本是直接在本地跑,还是提交到集群的某个队列里跑。
如果你什么都不配置,Nextflow 默认使用 local executor,也就是在你启动 Nextflow 的那台机器上直接运行所有任务。这非常适合开发和测试阶段——写代码、调逻辑、验证流程,直接在笔记本或工作站上就能跑
Nextflow真正强大的特性–执行抽象层
你只需要写一次流程代码(main.nf),然后通过修改配置文件(nextflow.config)中的 executor 设置,就可以无缝切换到不同的运行平台
// 本地运行(默认)
process.executor = 'local'

// 提交到 Slurm 集群
process.executor = 'slurm'

// 提交到 AWS 云端
process.executor = 'awsbatch'
3. Nextflow安装
Nextflow兼容所有的Linux发行版(Ubuntu、CentOS 等)和 macOS, Windows用户需要通过 WSL2(Windows Subsystem for Linux) 来运行。简单来说,就是在 Windows 里装一个 Linux 子系统,Nextflow 跑在这个子系统里
3.1 Java安装
Nextflow 要求 Java 17 以上,核心原因是 Nextflow 本身是用 Groovy 编写的,而 Groovy 运行在 JVM 上;从 Nextflow 22.10 版本开始,官方将最低运行时要求提升到了 Java 17
# 查看java版本
java --version
最推荐的方式是使用SDKMAN,可以方便的管理多个java版本
# 安装 SDKMAN
curl -s "https://get.sdkman.io" | bash
source "$HOME/.sdkman/bin/sdkman-init.sh"

# 安装 Java 17 LTS(Temurin 发行版,推荐)
sdk install java 17.0.10-tem

# 验证
java -version
# 输出: openjdk version "17.0.10" ...
当然也可使用系统包管理器
# Ubuntu/Debian
sudo apt install openjdk-20-jre

# CentOS/RHEL
sudo yum install java-20-openjdk

# macOS (Homebrew)
brew install openjdk@20
3.2 安装Nextflow
Nextflow 提供了多种安装途径,你可以根据自己的环境和使用习惯选择最合适的一种
| 方式 | 命令 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 自安装包(Self-installing package) | curl -s https://get.nextflow.io \| bash |
一键安装、支持 self-update 自动升级、维护最省心 |
需要联网 | 绝大多数用户的首选 |
| Conda 安装 | conda install -c bioconda nextflow |
与 Conda 环境统一管理、版本可控 | 版本可能滞后、偶尔有依赖冲突 | 已用 Conda 管理生信工具的用户 |
| 独立发行版(Standalone distribution) | 下载 nextflow-xx-dist 文件直接运行 |
无需联网、适合离线部署 | 需手动下载、手动更新 | 内网/离线服务器、需要定制化配置的场景 |
- 自安装包
# 下载并安装
curl -s https://get.nextflow.io | bash

# 赋予执行权限
chmod +x nextflow

# 移动到 PATH 目录
mkdir -p $HOME/.local/bin
mv nextflow $HOME/.local/bin/

# 确保 PATH 包含该目录(添加到 ~/.bashrc)
export PATH="$HOME/.local/bin:$PATH"- Conda安装
# 创建专用环境
conda create --name nextflow-env bioconda::nextflow
conda activate nextflow-env
4. 学习第一个脚本
安装好之后,就可以运行nextflow --version检查是否能够运行,接着这一节学习如何
- Running a pipeline:运行流程
- Modifying and resuming a pipeline:修改并恢复流程运行
- Configuring a pipeline parameter:配置流程参数
4.1 了解一个pipline
你将运行一个基础的 Nextflow 流程,该流程会将一段文本字符串拆分成两个文件,然后再将文件中的小写字母转换成大写字母
// Default parameter input
params.str = "Hello world!"

// split process
process split {
    publishDir "results/lower"

    input:
    val x

    output:
    path 'chunk_*'

    script:
    """
    printf '${x}' | split -b 6 - chunk_
    """
}

// convert_to_upper process
process convert_to_upper {
    tag "$y"

    input:
    path y

    output:
    path 'upper_*'

    script:
    """
    cat $y | tr '[a-z]' '[A-Z]' > upper_${y}
    """
}

// Workflow block
workflow {
    main:
    ch_str = channel.of(params.str)          // Create a channel using parameter input
    ch_chunks = split(ch_str)                // Split string into chunks and create a named channel
    ch_upper = convert_to_upper(ch_chunks.flatten()) // Convert lowercase letters to uppercase letters

    publish:
    lower = ch_chunks.flatten()
    upper = ch_upper
}

output {
    lower {
        path 'lower'
    }
    upper {
        path 'upper'
    }
}params是 Nextflow 内置的全局参数对象- 默认值为
"Hello world!",你可以在命令行通过--str覆盖它nextflow run main.nf --str "自定义文本"
process split
publishDir "results/lower":将该 Process 的输出文件自动发布(复制/链接)到results/lower目录,方便后续查看结果input: val x:接收一个值类型(字符串)output: path 'chunk_*':输出所有以chunk_开头的文件split -b 6 - chunk_:Bash 命令,按每 6 字节切分,生成 chunk_aa、chunk_ab 等文件
process convert_to_upper
tag "$y":给每个任务打上标签(显示在终端日志中),方便调试时识别是哪个文件在处理input: path y:接收上一步输出的文件路径output: path 'upper_*’:输出所有以upper_开头的文件
y是随手起的名称,可以换的
Workflow:数据流串联
main
channel.of(params.str):将字符串包装成 Channelsplit(ch_str):调用split Process,返回一个包含多个 chunk 文件的 Channelch_chunks.flatten():将 Channel 中的文件列表”展平”,使每个文件单独流向下游convert_to_upper(...):调用 convert_to_upper Process,将每个 chunk 转为大写
publish: 声明哪些 Channel 的结果需要被发布到输出目录
lower = ch_chunks.flatten():将拆分后的chunk文件发布到results/lowerupper = ch_upper:将转大写后的文件发布到results/upper
Output 块:定义发布路径
lower { path 'lower' }:lower 对应的文件发布到results/lower/upper { path 'upper' }:upper 对应的文件发布到results/upper/
运行后的目录
results/
├── lower/
│   ├── chunk_aa      # "Hello "(前6字节)
│   └── chunk_ab      # "world!"(后6字节)
└── upper/
    ├── upper_chunk_aa  # "HELLO "
└── upper_chunk_ab # "WORLD!"output:(process 内)—— 声明一个进程会产出什么文件或数据。publish:(workflow 内)—— 声明工作流要对外公开哪些 channel, 它是在工作流层面声明公开输出,便于外部用户、调用它的工作流或 Nextflow 的输出机制访问这些结果publishDir(process 内)—— 把进程产出的文件复制或链接到指定目录。publishDir使用符号链接方式发布文件;也可以通过配置选择复制等方式。output{}(workflow 外)—— 配置工作流公开的输出最终放到哪里。
4.2 运行pipline
- 在自己想放的文件中,创建
main.nf文件,把上述脚本放入文件中保存 - 在有
main.nf文件夹中运行nextflow run main.nf - 后续看到
 N E X T F L O W   ~  version 26.04.6

Launching `main.nf` [silly_fermi] revision: 55ca42d672

executor >  local (3)
[ae/949563] split (1)                   | 1 of 1 ✔
[97/71686b] convert_to_upper (chunk_aa) | 2 of 2 ✔

Outputs:

  /home/erwin/projectQiao/nextflow/results

  lower:
    - lower/chunk_aa
    - lower/chunk_ab

  upper:
    - upper/upper_chunk_aa
    - upper/upper_chunk_ab
Nextflow 会创建一个 work 工作目录来存放流程运行过程中产生的所有临时文件。流程中的每个 Process 会被拆分成一个或多个独立的 Task(任务) 来执行。在这个例子中,split 过程只执行了 1 个任务,而 convert_to_upper 过程因为接收到了两个 chunk 文件,所以执行了 2 个任务。终端里显示的类似 82/457482 这样的十六进制字符串,是一个唯一哈希值的前缀,用来标识每个任务对应的工作目录
4.3 修改pipline和resume
Nextflow 会在一个任务缓存(task cache)中记录所有任务的执行情况,这个缓存本质上是一个存储了历史任务记录的键值对数据库。任务缓存会和工作目录(work directory)配合使用,用来恢复那些已经跑过的任务。如果你修改了流程并加上 -resume 参数重新运行,Nextflow 只会重新执行那些被修改过的步骤;而对于没有发生变化的任务,它会直接复用之前缓存好的结果,完全不用重跑
- 打开
main.nf - 替换一个process
process convert_to_upper {
    tag "$y"

    input:
    path y

    output:
    path 'upper_*'

    script:
    """
    rev $y > upper_${y}
    """
}- 保存之后,继续运行
nextflow run main.nf -resume
5. 命令行操作模式
Nextflow也提供了强大的命令行控制方式
| 类型 | 标志格式 | 作用对象 | 用途 | 示例 |
|---|---|---|---|---|
| Nextflow 选项(Options) | 单破折号 - |
Nextflow 引擎本身 | 控制 Nextflow 的运行行为,如日志、工作目录、断点续跑等 | -resume、-log、-profile、-work-dir |
| Pipeline 参数(Parameters) | 双破折号 -- |
你的 Pipeline 脚本 | 传递数据给脚本中的 params.xxx 变量,如输入文件路径、输出目录等 |
--input、--outdir、--str |
接着上面的操作,你可以使用--来输入操作的字符
nextflow run main.nf --str 'Bonjour le monde':运行流程,并覆盖默认参数将看到字符被分为三个文件夹保存
N E X T F L O W   ~  version 24.10.3

Launching `main.nf` [distracted_kalam] DSL2 - revision: 082867d4d6

executor >  local (4)
[55/a3a700] process > split (1)           [100%] 1 of 1 ✔
[f4/af5ddd] process > convert_to_upper (chunk_ac) [100%] 3 of 3 ✔
Nextflow 提供了一个强大的命令行界面 (CLI),用于管理和执行管道。流水线执行是 Nextflow 的核心功能。这些命令可以运行 Nextflow 工作流,数据来源可以是本地文件或远程 Git 仓库。Nextflow 会自动处理流水线的下载、缓存和执行,最大限度地减少用户干预。
5.1 启动一个项目
run命令从本地文件或远程存储库执行管道脚本。它可自动管理存储库下载、缓存和执行,支持各种 Git 提供商和身份验证方法。
- Local pipelines
在含有 main.nf 文件的目录中运行,nextflow run main.nf
- Remote pipelines
使用 <organization>/<repository> 格式可以直接从 Git 存储库运行流水线:
nextflow run nextflow-io/hellonextflow将自动:
- 下载存储库到
$HOME/.nextflow/assets/ - 将其缓存以供将来运行
- Executes the main script
如果省略组织,Nextflow 将首先搜索缓存的管道,然后尝试从 NXF_ORG 组织(默认值:nextflow-io)下载, 你也可以直接使用URL链接
nextflow run https://github.com/nextflow-io/hello
- Private repositories
如果你要运行 GitHub 上的私有 Nextflow 仓库,需要提供身份验证凭据,才能访问仓库中的工作流代码。用户名只是身份验证信息的一部分,访问私有仓库还需要有效的认证凭据,例如密码、访问令牌或 SSH 密钥,具体取决于 Nextflow 的版本和仓库访问方式。
Nextflow 支持通过 ~/.nextflow/scm 配置仓库访问凭据。对于 GitHub 私有仓库,可以按对应版本的文档配置访问令牌(Token),而不是把令牌直接写在命令行中。
nextflow run organization/private-repo -user my-username- Non-GitHub providers
使用 -hub 选项指定 Bitbucket、GitLab 或其他 Git 提供商:nextflow run organization/repo -hub bitbucket
- Revision selection
nextflow run nextflow-io/hello -r v1.1
nextflow run nextflow-io/hello -r dev-branch
nextflow run nextflow-io/hello -r a3f5c8e
5.2 Pipeline parameters
管道参数是脚本中用 params 定义的值。您可以使用 -- 前缀在命令行中覆盖这些参数,从而自定义管道行为,而无需修改代码:nextflow run main.nf --input data.csv --output results
参数名称支持在 kebab-case(短横线命名法)和 camelCase(小驼峰命名法)之间自动转换。
- kebab-case 单词之间用短横线连接 input-file
- camelCase 从第二个单词开始首字母大写 inputFile
nextflow run main.nf --input-file data.csv # Becomes params.inputFile这个命令也是可以的如果参数中包含通配符(wildcards),要给参数值加上引号,防止 Shell 在执行命令前就把通配符展开
- Parameter files
对于复杂的参数集,请使用带有 -params-file 参数的 YAML 或 JSON 文件。这比冗长的命令行更简洁:
{
  "input": "data.csv",
  "output": "results/",
  "min_quality": 20
}
nextflow run main.nf -params-file params.json
- Parameter precedence
Nextflow 会按照以下顺序(从低到高)应用在多个位置定义的参数,意思是传递参数也是有优先级的
- 脚本参数
params.foo = 'default'最低 - 配置参数
- 参数文件(-params-file)
- 命令行参数(–foo bar)
5.3 Project management
项目管理命令与 Git 托管的流水线交互。Nextflow 与 Git 提供商(例如 GitHub、GitLab 和 Bitbucket)集成,将流水线视为版本化项目,并在 $HOME/.nextflow/assets/ 中维护本地缓存。
- Listing downloaded projects
list 命令显示当前已下载到本地缓存的所有流水线。这有助于您跟踪哪些项目可离线使用并管理缓存目录$HOME/.nextflow/assets/
nextflow list- Showing project information
info命令显示有关已下载项目的详细元数据,包括其存储库位置、本地路径、主脚本和可用版本。 使用它来了解项目的结构,查看可用版本,或验证当前签出的版本:
nextflow info hello具体显示内容如下
project name: nextflow-io/hello
repository  : https://github.com/nextflow-io/hello
local path  : $HOME/.nextflow/assets/.repos/nextflow-io/hello
main script : main.nf
revisions   :
> master (default)
  mybranch
> v1.1 [t]
v1.2 [t]- 完整的项目名称和存储库URL
- 本地缓存的地方
- 默认情况下运行哪个脚本
- 可用的版本(分支和标记为[t]的标签)
- Pulling or updating projects
pull命令从Git存储库下载管道或将现有管道更新为最新版本。使用它可以在管道运行之前手动下载管道,更新缓存的管道,或者下载离线使用的管道:
nextflow pull nextflow-io/hello

#  specify a particular revision to download
nextflow pull nextflow-io/hello -r mybranch- Viewing project code
view 命令显示管道主脚本的内容或列出存储库中的所有文件。使用此功能可以快速检查管道代码,而无需打开文件或浏览项目结构。指定 -l 选项会列出所有存储库文件,而不是显示脚本内容:
nextflow view nextflow-io/hello
nextflow view nextflow-io/hello -l- Cloning projects locally
clone 命令会将管道从缓存复制到本地目录,并创建一个完整的 Git 存储库,您可以对其进行修改。 当您需要修改现有流程、创建衍生流程或研究流程结构时,请使用此选项。如果省略目标目录,则使用流程名称
nextflow clone nextflow-io/hello my-hello- Deleting cached projects
drop 命令会从本地缓存中删除已下载的管道。使用此功能可删除不再需要的管道,从而释放磁盘空间。项目将从 $HOME/.nextflow/assets/ 中删除。下次运行时,如果需要,将重新下载该项目。
nextflow drop nextflow-io/hello5.4 Module management
module 命令允许您通过集中式模块注册表发现、安装和运行模块。
配置和验证选项及命令可帮助您控制和验证管道设置。配置选项可在运行时补充管道配置,而验证命令则可检查 Nextflow 如何解析您的配置文件、流程定义和脚本。使用它们可以自定义管道配置、调试配置问题、验证设置以及在执行前捕获问题。
- Soft configuration override
-c 选项会将您的配置添加到默认值之上,并将它们合并在一起。当您想要覆盖特定设置而保留其他默认设置时,请使用此功能。可以以逗号分隔的列表形式指定多个配置文件
nextflow -c my.config run nextflow-io/hello- Hard configuration override
-C 选项会将所有默认配置替换为您的自定义配置文件。多个配置文件可以用逗号分隔的列表形式指定。
核心是:-c 是合并配置,-C 是限制配置来源,只使用你指定的配置文件。
nextflow -C my.config run nextflow-io/hello- Configuration validation
config 命令会打印出管道的已解析配置,使用此功能可以调试配置问题、验证将应用哪些设置、了解配置优先级或检查特定配置属性。
nextflow config
nextflow config nextflow-io/hello
得到的是config的信息
> nextflow config nextflow-io/hello


process {
   container = 'quay.io/nextflow/bash'
}- Process inspection
inspect 命令分析管道中的流程设置,而无需执行该流程。它会以 JSON 或 Nextflow 配置格式输出容器信息。
nextflow inspect nextflow-io/hello
nextflow inspect nextflow-io/hello -format json
得到关于process中的设置
> nextflow config nextflow-io/hello


process {
   container = 'quay.io/nextflow/bash'
}- Script validation
lint 命令会分析 Nextflow 脚本和配置文件,查找语法错误和代码问题。它还可以自动格式化代码,以保持项目代码风格的一致性。使用此功能可在执行前捕获语法错误、强制执行一致的代码格式,或验证整个 Nextflow 代码目录:
nextflow lint main.nf5.5 Execution history
执行历史记录和维护命令用于管理过往运行记录并清理缓存文件。Nextflow 维护所有执行的元数据,并将中间文件存储在工作目录中。
使用这些命令可以查看过去的执行情况、释放磁盘空间、排查故障或探索数据沿袭。
- Execution logs
log 命令显示执行历史记录和过去管道运行的详细信息,例如运行名称、时间戳和可自定义的输出字段。用此命令可以查找运行名称以便恢复运行、查看执行历史记录或调试失败的运行。默认情况下,该命令显示最近的执行记录,并提供选项以查看特定运行记录或自定义输出字段:
nextflow log
nextflow log dreamy_euler
nextflow log last -f name,status,duration- Work directory cleanup
clean 命令会删除工作目录和过去执行过程中缓存的中间文件。使用此方法可以释放磁盘空间、清理失败或测试运行的文件,或维护您的工作目录。使用 -n 参数执行模拟运行并显示将要删除的内容。使用 -f 参数删除文件:
nextflow clean -n
nextflow clean dreamy_euler -f- Data lineage
lineage 命令探索工作流执行的数据沿袭和来源,并跟踪输入、输出和处理步骤之间的关系。使用此功能可以了解任务之间的输入/输出关系、跟踪数据在管道中的流动,或建立文件溯源。必须在配置中启用血缘跟踪:
nextflow lineage5. 软件控制
- nextflow updates
self-update命令会将 Nextflow 更新到更新的版本。它会下载并安装最新版本或指定版本。默认情况下,它会更新到最新的稳定版本:nextflow self-update
- Command help
help 命令会显示任何 Nextflow 命令的详细使用信息。
nextflow help run6. Configuration
nextflow.config文件的理解:
Nextflow 配置允许您在不修改流水线代码的情况下控制流水线的运行方式。您可以设置执行参数、定义资源需求、配置执行器和容器,并为不同的环境创建配置文件。
6.1 Configuration files
启动流水线脚本时,Nextflow 会检测来自多个来源的配置文件,并按以下顺序(从优先级最低到最高)应用它们:
$NXF_HOME/config(defaults to$HOME/.nextflow/config)nextflow.configin the project directorynextflow.configin the launch directory在启动目录- 使用
-c <config-files>指定配置文件
6.2 语法写法
Nextflow 配置使用的语法与 Nextflow 脚本类似。配置选项必须以声明的方式设置,但配置选项的值可以是任意表达式。配置文件可以包含任意数量的赋值语句、代码块和包含语句。
- Assignments(赋值)
简单来说,就是在 nextflow.config 中,给某个配置选项指定一个值.通过配置文件告诉 Nextflow,工作目录放在哪里、是否启用 Docker、进程最多允许多少错误等
workDir = 'work'
docker.enabled = true
process.maxErrors = 10
一个配置选项由配置名称以及它前面的零个或多个作用域组成。
- process: Scope(作用域)
- maxErrors: Option name(选项名)
配置值通常是一个字面量,但也可以是一个表达式
params.helper_file = "${projectDir}/assets/helper.txt"- Blocks
配置的写法, 同一个配置项,既可以用点号 . 逐层指定,也可以用花括号 {} 把相关配置组织起来。两种写法可以混合使用,最终表达的配置含义可以相同。
// dot syntax
docker.enabled = true
docker.runOptions = '-u $(id -u):$(id -g)'

// block syntax
docker {
    enabled = true
    runOptions = '-u $(id -u):$(id -g)'
}
可以采用多种方式为深度嵌套的配置选项赋值。以下三种赋值方式是等效的:
executor.retry.maxAttempt = 5

executor {
    retry.maxAttempt = 5
}

executor {
    retry {
        maxAttempt = 5
    }
}- Includes
您可以使用 includeConfig 关键字将配置文件包含在其他配置文件中:
process.executor = 'sge'
process.queue = 'long'
process.memory = '10G'

includeConfig 'path/extra.config'- 常量和函数
在 nextflow.config 配置文件中,有一些内置常量(Constants)和函数(Functions),可以直接使用,不需要自己定义
- Constants(常量):可以直接读取的预定义值,例如项目目录的路径。
- Functions(函数):可以调用来执行某种操作,例如根据环境变量名称获取对应的值
| 类别 | 名称 | 类型 / 参数 | 返回类型 | 说明 |
|---|---|---|---|---|
| 常量 | launchDir |
Path |
— | 启动工作流时所在的目录。 |
| 常量 | projectDir |
Path |
— | 主 Nextflow 脚本所在的目录。 |
| 常量 | workDir |
Path |
— | 工作流工作目录所在的位置。 |
| 常量 | secrets |
Map<String,String> |
— | 管道密钥的映射表。详见 Secrets。 |
| 函数 | env(name: String) |
name:环境变量名称 |
String |
获取启动 Nextflow 时所在环境中的指定环境变量值。自 Nextflow 25.04 起提供。 |
6.3 Parameters
文件中定义管道参数(Pipeline Parameters)以及参数的声明位置、配置文件的加载顺序和 Profile 覆盖机制。
// dot syntax
params.max_cpus = 64
params.publish_mode = 'copy'

// block syntax
params {
    max_cpus = 64
    publish_mode = 'copy'
}| 文件 / 位置 | 作用 | 示例 |
|---|---|---|
main.nf |
声明工作流脚本需要的参数,特别是输入参数 | params.input = null |
nextflow.config |
设置默认配置值,以及其他配置项需要使用的参数 | params.publish_mode = 'copy' |
profiles |
针对不同运行场景覆盖参数 | params.input = "${projectDir}/test/input.txt" |
| 命令行 | 启动时临时覆盖参数 | --input data/sample.csv |
6.4 Process configuration
Nextflow 配置文件中的 process 作用域,用于将进程执行配置与工作流代码分离。
process {
    executor = 'sge'
    queue = 'long'
    clusterOptions = '-pe smp 10 -l virtual_free=64G,h_rt=30:00:00'
}| 配置项 | 含义 | 示例值 |
|---|---|---|
process |
配置所有进程的默认执行设置 | process { ... } |
executor |
指定任务执行器,即任务提交到哪里运行 | 'sge':Sun Grid Engine |
queue |
指定任务提交到的队列 | 'long':长任务队列 |
clusterOptions |
向集群调度系统传递额外的提交参数 | '-pe smp 10 -l virtual_free=64G,h_rt=30:00:00' |
- Process selectors
Nextflow 配置中的 Process selectors(进程选择器),用于针对带有特定标签的进程,或指定名称的进程,设置不同的资源和执行参数
| 选择器 | 作用 | 匹配依据 | 适用场景 |
|---|---|---|---|
withLabel |
配置所有具有指定标签的进程 | label 标签 |
为大内存任务统一分配资源 |
withName |
配置指定名称的进程 | 进程名称或完全限定名称 | 单独配置某个进程的资源 |
在nextflow.config中进行process,withLabel的设置,然后在main.nf中加入label,表示该过程使用的CPU,内存等;而withName就能够配对process的名字来进行分配
process {
    withLabel: big_mem {
        cpus = 16
        memory = 64.GB
        queue = 'long'
    }
}
此配置将 16 个 CPU、64 GB 内存和长队列分配给所有带有 big_mem 标签的进程
process {
    withName: hello {
        cpus = 4
        memory = 8.GB
        queue = 'short'
    }
}
与 withLabel 不同,withName 不要求进程事先定义特定标签,而是直接根据进程名称进行匹配。
在嵌套工作流中,进程名称可能包含多个工作流层级。此时可以使用完全限定名称(Fully Qualified Name)。
- Selector expressions
您可以在流程选择器中使用正则表达式,将相同的配置应用于所有与该模式匹配的流程。
process {
    withLabel: 'hello|bye' {
        cpus = 2
        memory = 4.GB
    }
}
使用 ! 运算符可以对选择器表达式取反
- Selector priority
当同一个进程同时匹配多条配置时,Nextflow 按以下顺序应用配置,越靠后,优先级越高。
| 优先级 | 配置来源 | 示例 |
|---|---|---|
| 1(最低) | process 全局配置 |
process { cpus = 4 } |
| 2 | 进程定义中的指令 | process HELLO { cpus 2 } |
| 3 | 匹配的 withLabel |
withLabel: hello { cpus = 8 } |
| 4 | 匹配原始进程名称的 withName |
withName: bye { cpus = 16 } |
| 5 | 匹配导入别名的 withName |
withName: sayBye { cpus = 24 } |
| 6(最高) | 匹配完全限定名称的 withName |
withName: 'aloha:bye' { cpus = 32 } |
而’aloha:bye’ 是进程的完全限定名称(Fully Qualified Name),由工作流名称和进程名称组成,中间用冒号分隔。防止同一个进程可能在不同的工作流中被调用。
- Disabling processes
如何在 nextflow.config 中临时关闭某个进程,或者根据条件决定某个任务是否执行
你可以把 when 理解为进程的一个“执行门禁”:条件满足,任务执行;条件不满足,任务跳过。
process {
    withName: 'FASTQC' {
        when = false
    }
}
找到名为 FASTQC 的进程,将它的 when 条件设为 false,使它不执行任何任务。
6.5 Config Profiles
配置文件可以定义一个或多个配置文件。配置文件是一组配置设置,可以在运行时使用 -profile 命令行选项进行选择。
Nextflow 的 Config profiles(配置配置档案)。它的核心作用是:同一套工作流代码,可以根据运行环境切换不同的配置,而不需要修改 main.nf。
你可以在本地电脑测试,在公司服务器运行正式分析,或者在云端执行,都使用同一个工作流,只切换 Profile
profiles {
    standard {
        process.executor = 'local'
    }

    cluster {
        process.executor = 'sge'
        process.queue = 'long'
        process.memory = '10GB'
    }

    cloud {
        process.executor = 'cirrus'
        process.container = 'cbcrg/imagex'
        docker.enabled = true
    }
}
如何切换Profile
# 使用 standard 配置
nextflow run main.nf -profile standard

# 使用 cluster 配置
nextflow run main.nf -profile cluster

# 使用 cloud 配置
nextflow run main.nf -profile cloud
重要规则:多个 Profile 的应用顺序由配置文件中定义它们的顺序决定,而不是命令行中填写的顺序。
| Profile | 适用场景 | 主要配置 |
|---|---|---|
standard |
默认配置 | 项目的标准运行配置 |
local |
本地运行 | 使用 local 执行器 |
cluster |
集群运行 | 使用 SGE 执行器、long 队列、10 GB 内存 |
cloud |
云端运行 | 使用 cirrus 执行器、指定容器并启用 Docker |
7. Executors
在 Nextflow 中,Executors(执行器)决定每个 Process 的任务由哪里、以什么方式执行。
可以把 Nextflow 理解成一个工作流调度器:它负责管理任务之间的依赖关系,而 Executor 负责把任务提交到相应的计算环境中运行。
| Executor | 运行环境 | 适用场景 |
|---|---|---|
local |
当前计算机 | 学习、测试、小规模分析 |
sge |
Sun Grid Engine 集群 | 使用 SGE 的 HPC 集群 |
slurm |
Slurm 集群 | 使用 Slurm 的 HPC 集群 |
pbs |
PBS / PBS Pro 集群 | 使用 PBS 的计算集群 |
lsf |
IBM LSF 集群 | 使用 LSF 的计算集群 |
awsbatch |
AWS Batch | AWS 云端批量计算 |
google-lifesciences |
Google Cloud | Google Cloud 相关计算环境 |
k8s |
Kubernetes | Kubernetes 集群 |
可以在process中 写
process {
    executor = 'local'
    cpus = 4
    memory = '8 GB'
}
8. Caching and resuming
Nextflow 的核心特性之一是能够缓存任务执行结果并在后续运行中重复使用,从而最大限度地减少重复工作。这种可恢复性对于从错误中恢复以及迭代开发流程都非常有用。它类似于检查点机制,后者是高性能计算 (HPC) 应用中常用的做法。
您可以使用 -resume 标志在 Nextflow 中启用断点续传功能,该标志用于在启动管道时运行 nextflow run 命令。大多数情况下,断点续传功能都能正常工作。
8.1 Task cache
所有任务执行都会自动保存到任务缓存中,无论是否使用 -resume 选项(这样您始终可以选择稍后恢复执行)。任务缓存是一个键值存储,其中每个键值对对应于一个先前执行过的任务。
| Key(任务哈希) | Value(任务记录) |
|---|---|
a81f... |
FASTQC 任务的执行记录 |
b92c... |
STAR_ALIGN 任务的执行记录 |
c73d... |
MULTIQC 任务的执行记录 |
任务缓存(Task cache)需要与工作目录(Work directory)配合使用,才能在恢复运行时找回并复用缓存任务。此外,Nextflow 的 log 子命令也会使用任务缓存来查询任务元数据。
- Task hash
任务哈希(Task hash)是根据以下元数据计算得出的:
- Session ID(会话 ID):参见 workflow 命名空间中的 workflow.sessionId
- Task name(任务名称):参见 Trace 文件中的 name 字段
- Task container image(任务容器镜像)
- Task environment modules(任务环境模块)
- Task Conda environment(任务 Conda 环境)
- Task Spack environment(任务 Spack 环境)和 CPU architecture(CPU 架构)
- Task inputs(任务输入)
- Task eval commands(任务 eval 命令)
- Task script(任务脚本)
- Global variables referenced in the task script(任务脚本中引用的全局变量)
- 任务脚本中使用的任何捆绑脚本(bundled scripts)
- 任务是否以 Stub 模式运行(stub run)
- Task entry
任务条目是一个序列化的数据块(serialized blob),其中保存了恢复某个任务运行所需的元数据,包括:
- Trace 文件中使用的字段
- 任务的输入变量
Task entry 可以理解为 Nextflow 为一个任务保存的一份可供恢复使用的记录
- Cache stores
默认缓存存储使用相对于启动目录(即 workflow.launchDir)的 .nextflow/cache 目录来存储任务缓存,每个会话 ID 都有一个单独的子目录,由 LevelDB 提供支持。
由于 LevelDB 的限制,给定会话 ID 的数据库一次只能由一个读取器/写入器访问。这意味着,例如,您无法在管道运行期间使用 Nextflow 日志查询其任务元数据。
8.2 Work directory
任务缓存存储任务元数据以供后续运行使用,而工作目录存储管道运行期间使用的各种文件。
每个任务都使用基于其哈希值的唯一目录。创建任务时,Nextflow 会将任务输入文件、脚本和其他辅助文件暂存到任务目录中。任务执行期间会将所有输出文件写入此目录,Nextflow 会将这些输出文件用于下游任务和/或发布。
当程序恢复运行时,如果从任务缓存中检索到之前的任务,Nextflow 会检查工作目录中对应的任务目录。如果所有必需的输出都存在且退出代码有效,则任务缓存成功;否则,任务将重新执行。
当应该被缓存的任务被重新执行,或者应该被重新执行的任务被缓存时,就会发生缓存失败。
- 恢复功能未启用
- 缓存指令已禁用
- 修改后的输入
- 全局变量上的竞态条件
9. Reports
9.1 Execution log
nextflow log 命令显示有关过去流水线运行和任务执行的信息。您可以按运行名称或会话 ID 进行查询,该命令还提供了多个选项来筛选和格式化输出。
$ nextflow log
TIMESTAMP               DURATION        RUN NAME                STATUS  REVISION ID     SESSION ID                              COMMAND
2025-12-09 11:43:18     1s              naughty_heisenberg      OK      2ce0b0e294      bae65ec6-a2b9-49bf-b63e-2fec91945e48    nextflow run hello
2025-12-09 11:43:28     931ms           thirsty_swanson         OK      2ce0b0e294      bae65ec6-a2b9-49bf-b63e-2fec91945e48    nextflow run hello -resume
2025-12-09 11:43:37     8.5s            goofy_kilby             OK      ca20a6dfd2      d0a60572-076e-451a-b10e-16059ed77e36    nextflow run rnaseq-nf -profile conda
提供运行名称或会话 ID 会打印出该管道运行执行的任务:
$ nextflow log goofy_kilby
/Users/user/workspace/work/e1/fc2d06782f8263476426c576888033
/Users/user/workspace/work/72/f0542cfa81ad6abeaf1adf02e5cc2b
/Users/user/workspace/work/83/009346a3958358bb704e996d935c7a
/Users/user/workspace/work/84/15e4cd16df1db6f9bc0e22cc05316d- Customizing fields
-f(-fields)选项指定要包含在日志中的字段
nextflow log <run-name> -f [fields]可以设置自定义字段列表,以关注特定信息, 常见的有hash,name,exit等
$ nextflow log goofy_kilby -f hash,name,exit,status
e1/fc2d06       RNASEQ:INDEX  (ggal_1_48850000_49020000) 0       COMPLETED
72/f0542c       RNASEQ:FASTQC (ggal_gut)                 0       COMPLETED
83/009346       RNASEQ:QUANT  (ggal_gut)                 0       COMPLETED
84/15e4cd MULTIQC 0 COMPLETED- Templates
-t选项指定在检查单个运行时使用的模板(字符串或文件):
nextflow log <run-name> -t <template> > <report>

nextflow log goofy_kilby -t my-template.md > execution-report.md
自己搭建一个模板文件,或者使用AI进行搭建
- Filtering
filter选项选择要包含在日志中的条目 nextflow log <run-name> -filter '<filters>'
9.2 Execution report
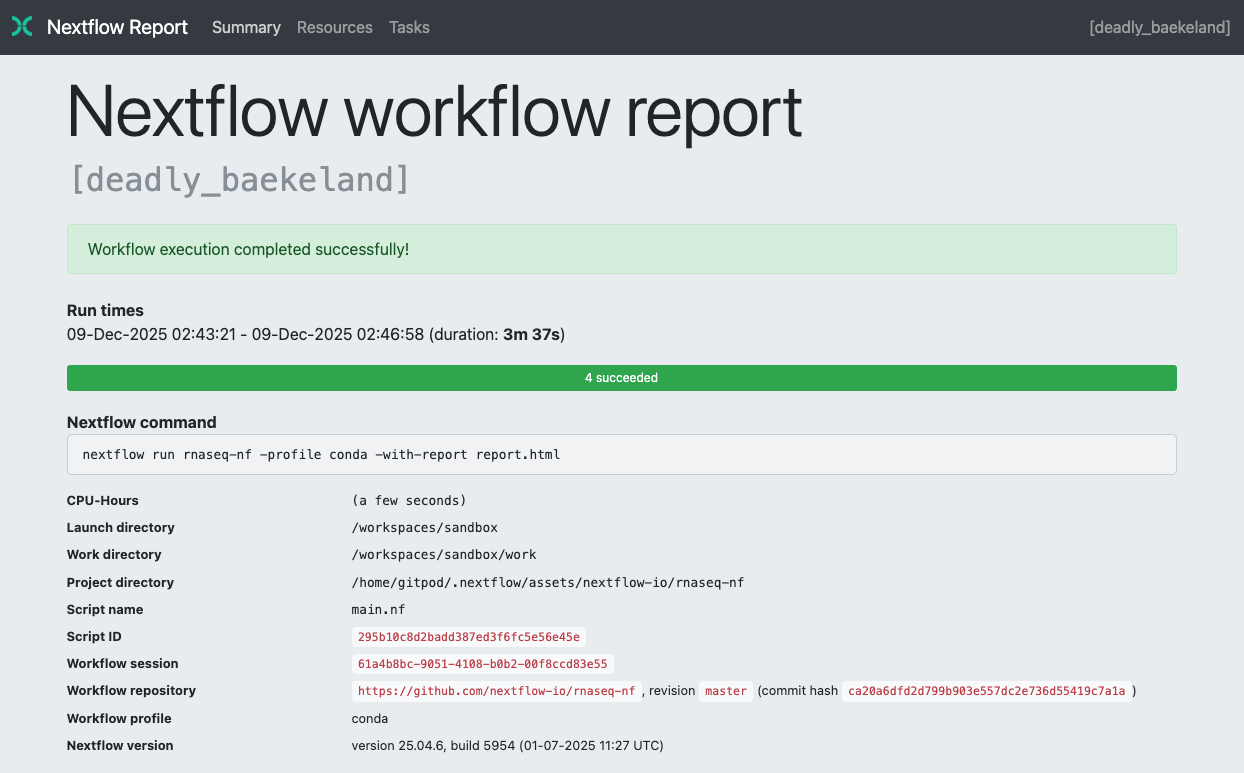
执行报告是一个HTML报告,其中包含有关管道运行的指标。该报告分为三个部分:摘要、资源和任务。
要启用执行报告,在启动管道运行时添加-with-report选项
nextflow run <pipeline> -with-report [file_name]形成的html部分主要分成三部分介绍:
- Summary
总结页面:Summary部分报告执行状态、启动命令、总体执行时间和其他工作流元数据
- Resource usage
Resources section plot部分使用交互式plot .js绘图库绘制了每个工作流过程的资源使用分布,图中显示了CPU、内存、作业持续时间和磁盘I/O。每个使用指标都以原始形式和所请求资源的百分比显示。这些图有助于检查任务资源的有效利用。
- CPU
- Tasks
- Memory
- Job Duration
- I/O
- Tasks
9.3 Execution timeline
执行时间轴是一个HTML报告,显示了在管道运行中执行的任务的时间轴:
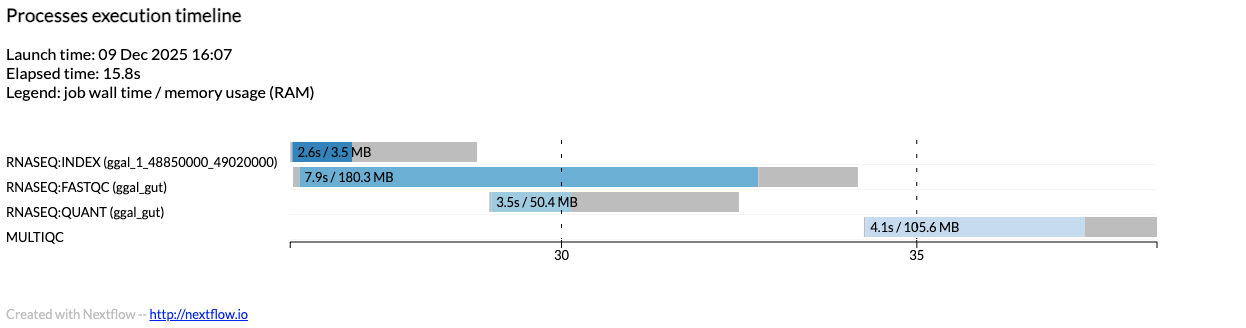
nextflow run <pipeline> -with-timeline [file_name]第一次使用会下载相关依赖
| 原文 | 翻译 | 含义 |
|---|---|---|
| Bar length: Task duration (duration) | 条形长度:任务总耗时(duration) | 整个条形的长度表示这个任务从开始到结束总共花了多长时间 |
| Bar color: Identifies tasks from the same process | 条形颜色:标识来自同一个 process 的任务 | 同一个 process 定义出来的任务会用相同颜色,方便你一眼区分不同 process |
| Colored area: Real execution time (realtime) | 彩色区域:实际执行时间(realtime) | 条形里有颜色的部分表示任务真正在运行的时间,也就是脚本实际执行所花的时间 |
| Gray area (left): Task scheduling time (start - submit) | 左侧灰色区域:任务调度等待时间(start - submit) | 任务被提交后,到真正开始执行之间的等待时间,比如排队、调度、启动容器/环境等 |
| Gray area (right): Task termination time (complete - start - realtime) | 右侧灰色区域:任务结束收尾时间(complete - start - realtime) | 任务脚本执行完后,到 Nextflow 标记它完全结束之间的时间,可能包括结果回收、状态更新等 |
| Label: Task duration (duration) and peak memory usage (peak_rss) | 标签:任务总耗时(duration)和峰值内存占用(peak_rss) | 条形上的文字会显示这个任务一共花了多久,以及运行时最高用了多少内存 |
一个任务条形图 = 左边灰色等待 + 中间彩色真正运行 + 右边灰色收尾
9.4 Trace file
跟踪文件是一个CSV文件,其中包含有关管道运行中执行的每个任务的信息,包括提交时间、开始时间、完成时间、CPU使用情况和内存使用情况。
nextflow run <pipeline> -with-trace上面的命令在当前目录中创建一个名为trace.txt的文件。
Nextflow通过一个后台进程为目标环境中的每个作业收集跟踪指标。确保在执行任务的环境中有以下工具可用:awk、date、grep、ps、sed、tail、tee。不包括所有这些工具的容器映像可能导致丢失数据
9.5 Workflow diagram
Nextflow管道可以表示为有向无环图(DAG)。图中的顶点表示管道的进程和操作符,而边表示它们之间的数据依赖关系(即通道)。要呈现工作流DAG,请使用-with-dag选项运行管道。默认情况下,它会创建一个名为dag-<timestamp>.html的文件,其中工作流dag呈现为一个Mermaid图。
通过根据所需的格式指定具有不同扩展名的输出文件名,可以以不同的格式呈现工作流DAG。
nextflow run main.nf -with-dag flowchart.png使用-preview选项和-with-dag来呈现工作流DAG,而不执行任何任务。
nextflow run rnaseq-nf -preview -with-dag