Abstract
药物开发需要跨生物尺度和模式的证据整合,但相关工具是碎片化的。我们介绍虚拟Virtual Biotech,这是一个以药物开发公司为模型的人工智能(AI)agent组织,其agent分布涵盖目标发现、安全性评估、模式选择和临床开发。作者在三个药物开发决策点展示了它的效用。首先,超过37,000个agents对55,984项试验的结果进行了注释,发现针对细胞类型特异性基因的药物进入市场的可能性提高了48%,不良事件减少了32%。其次,它整合了多模式证据,提出了一种治疗肺癌的策略。第三,分析了一项终止性溃疡性结肠炎试验,并推断了失败的潜在机制。这些结果表明,人类引导的多主体系统可以进行透明的多尺度分析,为治疗开发决策提供信息。
Introduction
药物发现是生物医学领域最重要和最具挑战性的工作之一。将一种治疗方法从概念应用到临床,通常需要十多年的发展,耗资数十亿美元。尽管有这些投资,但大约90%进入I期试验的候选药物从未获得批准,失败的最常见原因是有效性和安全性不足。为了减少这种损耗,现代药物发现越来越多地利用来自不同来源的证据来验证靶标,包括但不限于人类遗传学、功能基因组学、单细胞和空间谱、结构生物学、药物化学和临床医学。
组织和科学上的瓶颈限制了这些证据在实践中的正确使用。收集和分析数据的专业知识在学科、格式和生物尺度上是分散的,产生了孤立的工作流程。此外,权衡不同的、有时相互矛盾的证据是困难的,特别是当组织动态或不同的先前信念影响决策时。分散的团队也会以不同的方式记录他们的工作流程,这使得结果难以审核,决策难以重建,此外,最近生物数据规模的爆炸式增长使得跨模式的人工整合更加困难。因此,尽管数据驱动的方法取得了进展,但早期药物开发仍然缓慢,资源密集,并且容易失败.
人工智能(AI)agent 被提议加速涉及广泛数据分析的科学任务,因为它们是配备了工具和数据库的语言模型,使它们能够自主执行复杂的多步骤任务。指定角色并提供特定于领域的工具,例如生物信息学软件,可以使agent专门化,以完成一类任务。最近的研究还探讨了多智能体系统,其中多个专门的智能体协作解决复杂的问题。
在这里,我们介绍 Virtual Biotech,这是一个多智能体人工智能研究平台,可以检索,分析和整合多模式证据,以回答早期人类治疗发现中的科学问题。虚拟首席科学官(CSO)协调者将查询分解为可管理的子任务,将其引导给专门的AI科学家agent,并对其结果进行解释。这种结构化的协作鼓励对主要证据进行深入的数据驱动分析,并允许使用统一的推理层对不同来源的证据进行权衡,从而得出细微差别的结论。
Agent 系统已经在化学和人工智能研究自动化等科学领域显示出前景。在生物医学领域,针对特定工作流程的agent方法已经出现,其应用包括基因编辑、空间和单细胞组学、罕见疾病诊断和纳米体设计。尽管如此,这些框架主要集中在生物数据分析上,并且通常由单一代理控制。相比之下,Virtual Biotech是一个多Agent系统,明确设计用于整个人类治疗研发管道的转化推理。通过对大规模和复杂的药物发现数据进行协调分析,该系统可以用整体的、数据驱动的推理来回答科学问题。
Results
Virtual Biotech总览
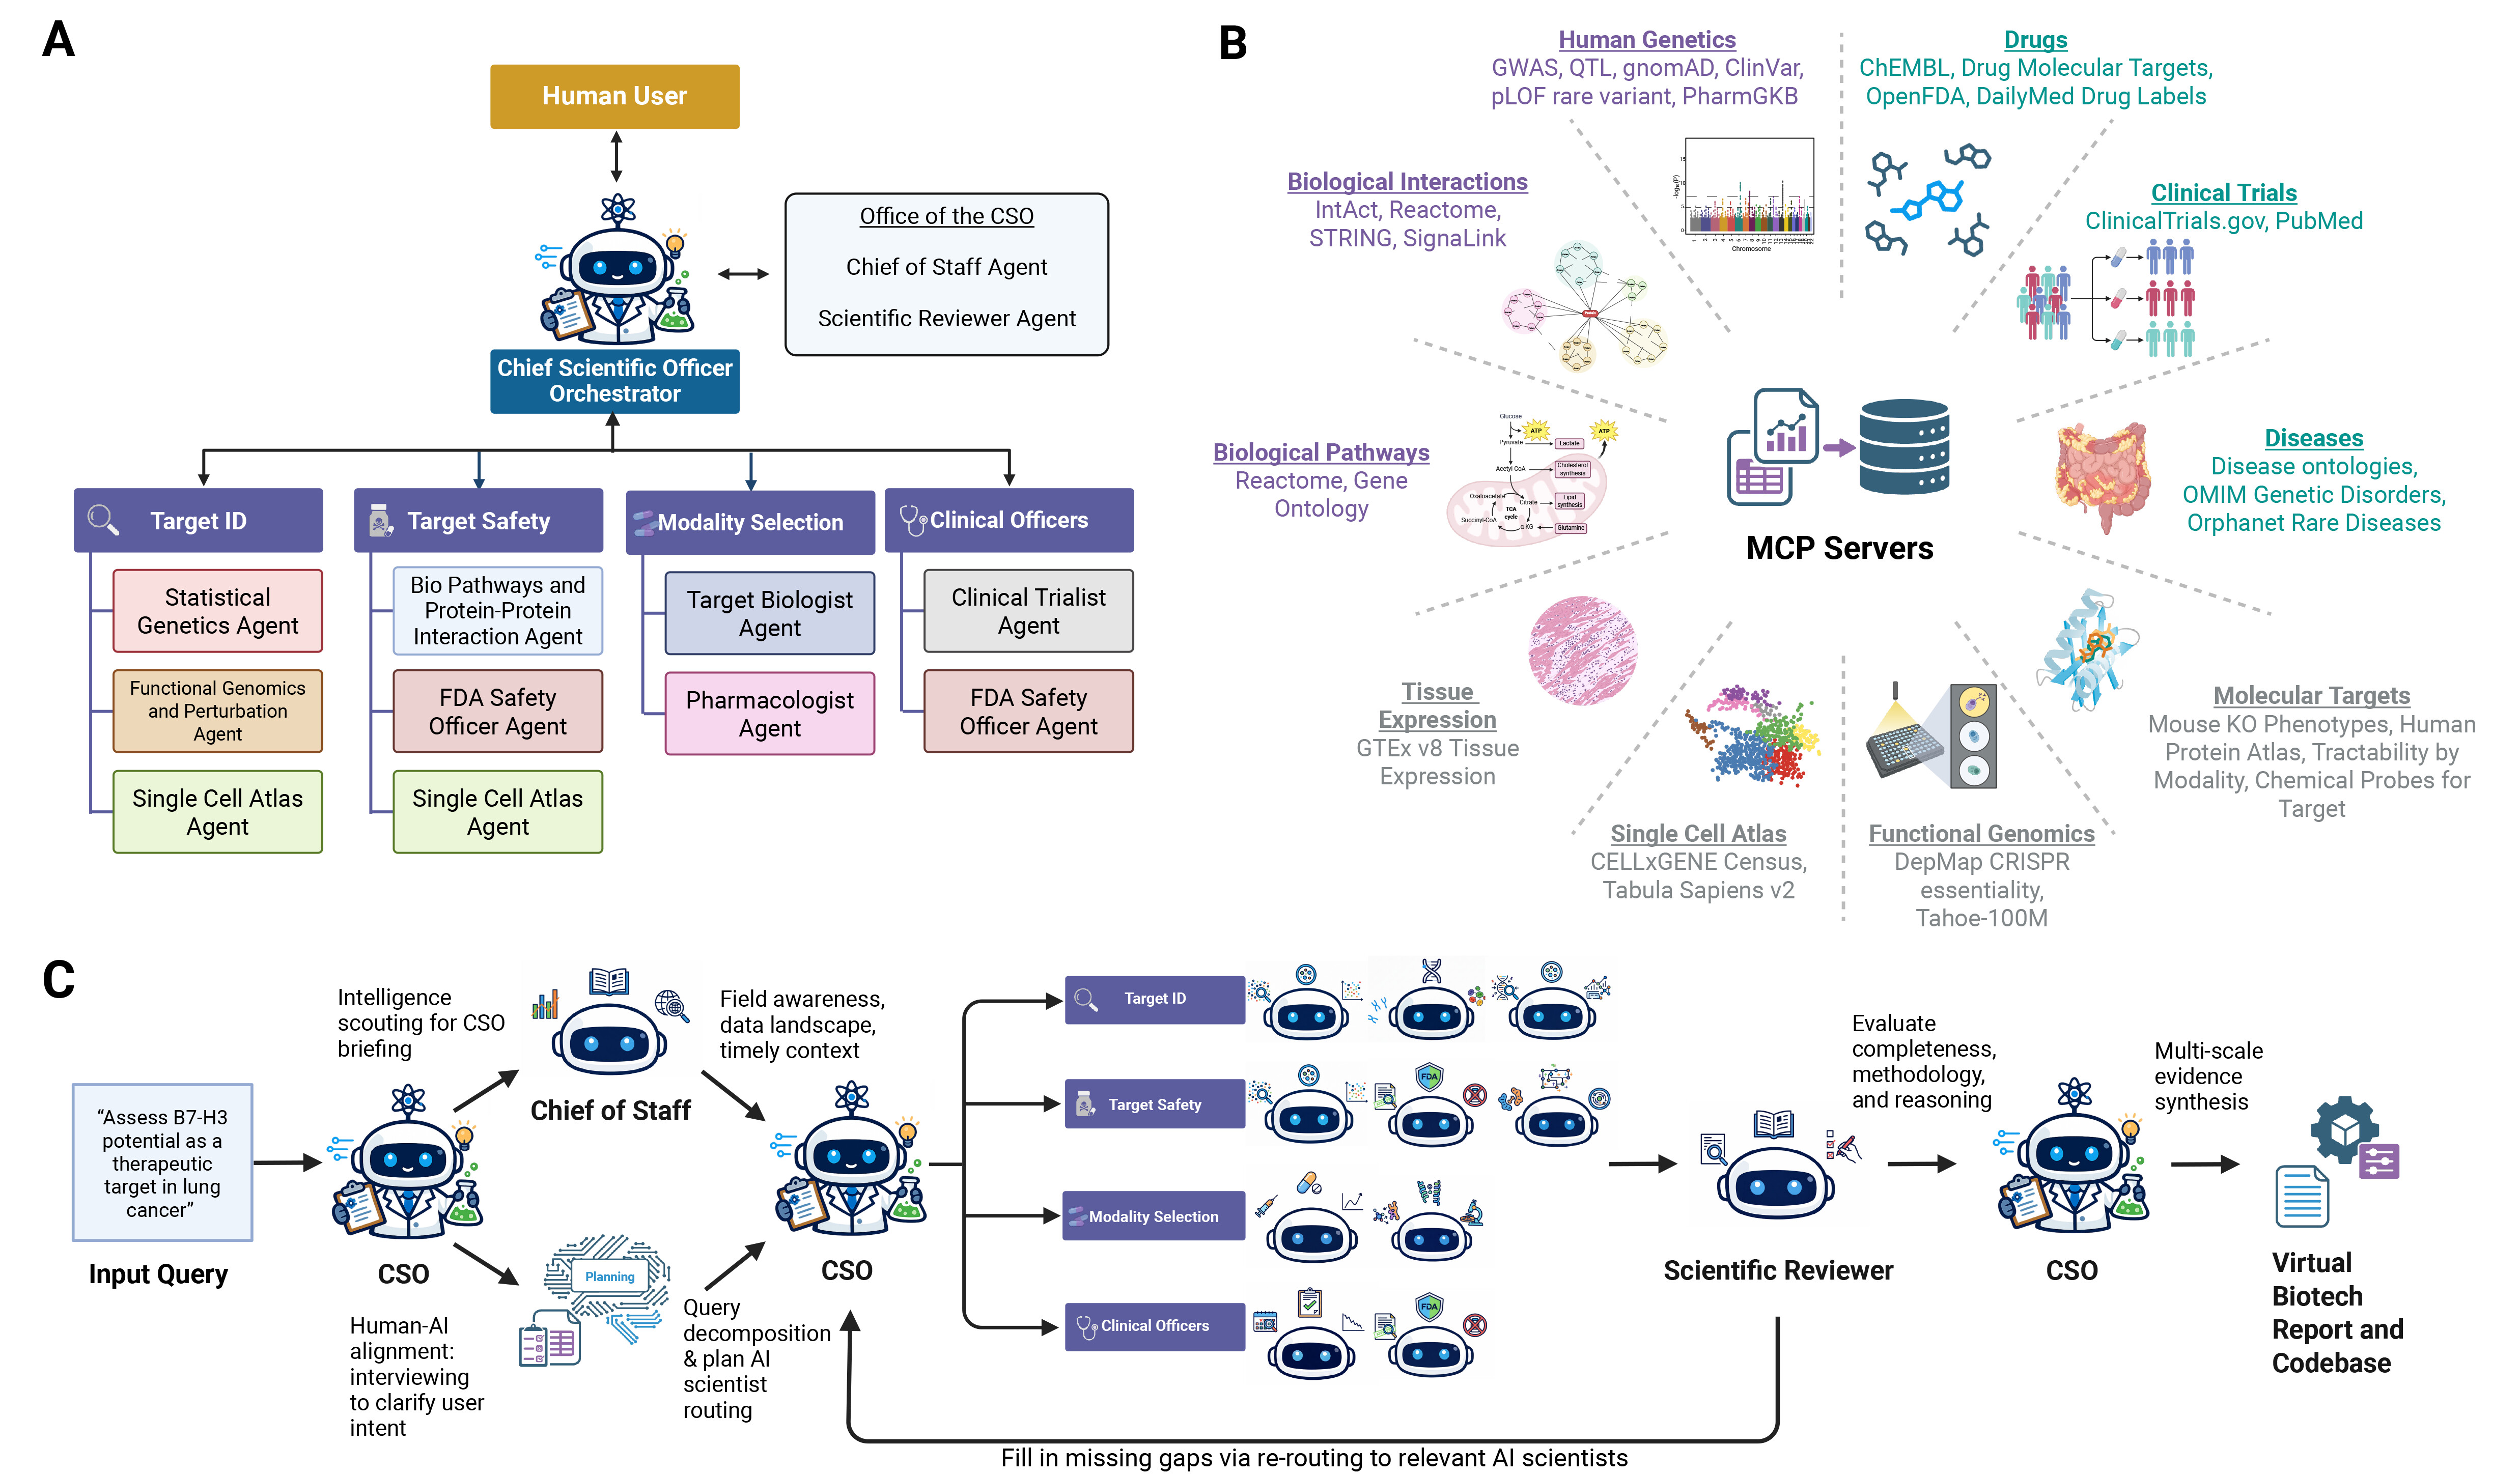
The Virtual Biotech 模拟了一个跨功能的治疗研究组织。它由四个科学家agent部门组成,解决药物发现管道的关键步骤。每个部门的领域专业科学家agent都有互补的专业知识和领域特定工具,使他们能够查询、分析和整合跨翻译谱的生物医学信息,以对药物发现问题进行循证评估
 {fig-alt=“figure1”, fig-align=“center”}
作者创建了特定领域的模型上下文协议 (MCP) 服务器,为主要的生物医学数据库和知识库提供统一的编程接口,将异构数据格式和查询 API 的复杂性抽象为标准化工具(Figure 1B). 每个科学家agent都可以访问经过筛选、与其专业知识相匹配的 MCP 工具,从相关来源收集证据,将静态数据库转化为交互式知识层,代理可以根据用户问题动态分析这些知识层。
作者开发了专门的MCP,为虚拟生物技术科学家agent提供100多种分析工具,用于查询涵盖78,726个靶点、39,530种疾病、1450万个蛋白质-蛋白质相互作用、超过300万个可信基因组集以及超过1亿个单细胞谱的大规模异构生物医学数据。平台进一步整合了化学信息学和药理学资源,涵盖 18,119 种药物、6,332 种不同的作用机制、114,270 份 FDA 不良事件报告、32,783 个药物基因组变异以及来自 Tahoe-100M 的药物扰动表达测量数据。可以通过PubMed进一步查询生物医学文献,并通过网络工具检索更多目标数据集。这些资源主要以人为本,因此支持针对人类疾病的靶向查询。作者为虚拟生物技术平台开发了一个用户界面,该界面可以显示智能体的推理过程,指示当前正在使用的工具,并允许用户下载每次会话期间生成的相应数据、可复现代码和报告。
Virtual Biotech 流程
虚拟首席科学官在收到用户查询后、启动科学工作之前,会启动自身的战略方向调整。其首席参谋官首先生成一份关于总体现场情况、数据格局和最新进展的简报,以帮助虚拟首席安全官构建分析框架,为用户设定适当的可行性预期,并确定关键问题. 与此同时,虚拟首席安全官会与用户进行访谈,以明确用户意图,并提高人机协作的一致性。虚拟首席安全官 (CSO) 完成任务后,会将任务分配给相关的科学家agents.
科学家agent完成分析后,科学审阅agent会评估他们的输出结果,以了解这些结果对用户最初问题的解答程度、支持其结论的证据强度以及分析的整体全面性.如果科学审查员发现存在漏洞或未经证实的说法,首席科学官将把审查工作重新委托给相关的科学家进行迭代完善。
靶点优先级排序:Virtual Biotech 将临床前生物学与临床结果相结合,以识别与临床试验成功相关的药物靶点特征
药物研发项目面临着巨大的损耗,其中疗效不足和安全问题约占临床试验失败的79%。先前的靶点优先排序工作表明,有人类遗传证据支持的靶点更有可能进入临床开发阶段。先前的靶点优先排序工作表明,有人类遗传证据支持的靶点更有可能进入临床开发阶段。虚拟 CSO 使用其临床试验代理,通过添加额外的结果注释来丰富包含 55,984 项试验的 Open Targets 临床试验数据集。它还提议利用其单细胞试剂设计基因组特征,以进行与试验结果的关联性测试,遵循 Razuvayevskaya 等人的研究。由于原始的 Open Targets 数据集缺乏终点数据,而 ClinicalTrials.gov 记录通常提供不完整、不一致或仅包含自由文本的结果,因此需要基于代理的结果标注。因此需要Agent机构进行数据整理,以规范结果并从出版物和新闻稿等来源中恢复缺失或冲突的数据。
大规模并行、溯源提取试验结果
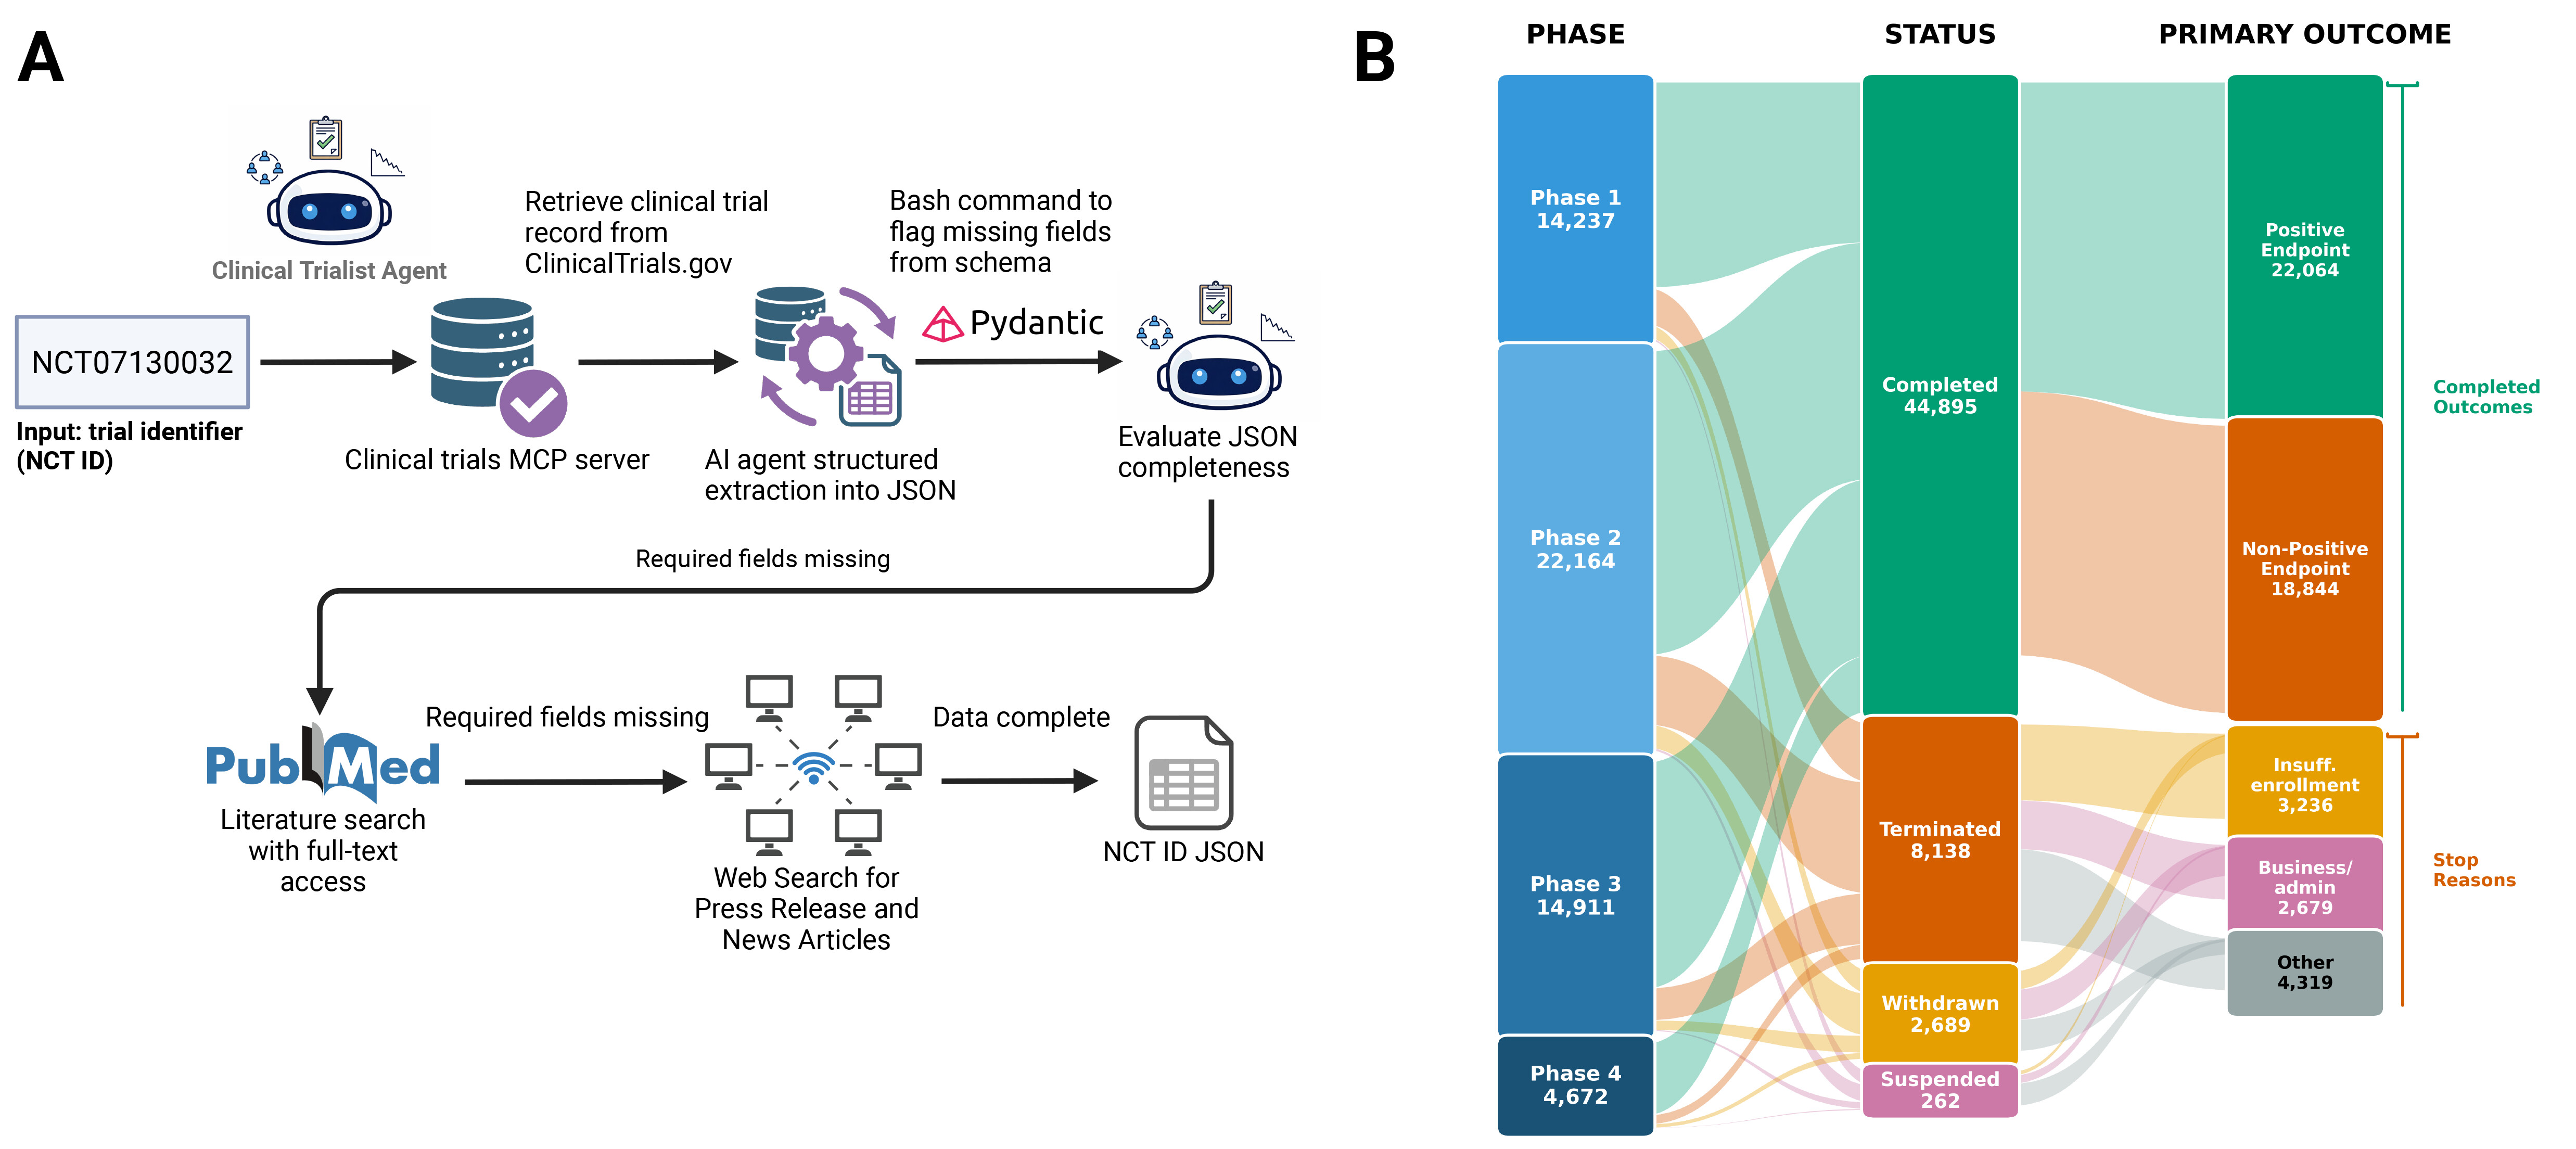
临床试验agent提出了大规模提取的关键结果变量, 包括试验阶段进展、主要和次要终点结果以及不良事件发生率。它制定了一套系统化的方案,从出版物和新闻稿等来源获取试验结果。工作流程始于人类用户指示虚拟 CSO 整理 Open Targets 数据集中的 II 期和 III 期临床试验结果。虚拟首席战略官将此目标转化为分布式提取任务,并将方案设计委托给临床试验agent,由其明确所需的结果字段、证据层级和来源追踪要求。虚拟 CSO 随后并行派遣了 37,075 名临床试验参与者,每个国家临床试验标识符 (NCT ID) 对应一名参与者,在这个规模下,如果没有并行化,全面的数据管理是不切实际的,因此需要一个能够以分布式方式执行数据管理的多代理架构。
 {fig-alt=“figure2”, fig-align=“center”}
每个临床试验参与者都遵循其分配的 NCT ID 的三级证据级联:首先系统地查询 ClinicalTrials.gov 数据库,然后在原始数据不完整时在 PubMed 中搜索包含试验结果的出版物,最后查阅在线新闻稿和监管公告。Agent 记录每条注释的信息来源。每次试验的中位成本为0.23美元(Anthropic API费用)。对于I期试验,成功通过算法定义为进入II期试验,因为I期试验评估的是安全性和剂量,而非疗效。
为了评估注释质量,对 100 项随机选择的临床试验进行了人工审查,结果显示,主要终点的一致性为 88.4%(86 项适用试验中有 76 项),次要终点的一致性为 88.4%(86 项中有 76 项),不良事件发生率的一致性为 92.4%(66 项中有 61 项报告了确切的统计数据)。此外,在与人工整理的治疗数据共享(TDC)试验结果预测数据集重叠的 7,666 项试验中,主要终点的一致性为 85.6%(更多详情请参见材料和方法)。
利用单细胞图谱进行转化特征工程
为了提取药物靶点的单细胞表达特征,单细胞agent提出并实现了一个针对 Tabula Sapiens(包含 27 种组织的健康人类参考图谱)的综合特征提取框架。该agent设计的特征分为两类:细胞类型特异性指标和表达异质性指标.
为了提高特异性,该agent提出了tau细胞类型特异性指数,其中接近于零的值表示普遍表达,而接近于一的值表示表达仅限于单一细胞类型。
为了捕捉细胞群体内的表达异质性,该agent提出了一种双峰系数,该系数由表达细胞间表达分布的偏度和峰度计算得出,其中较高的值可能表示组织内“开/关”的表达模式。针对基因表达分析,人们提出了多种双峰性测量方法,但这种最初在心理学/社会科学领域发展起来的特定双峰性系数,对于基因表达双峰性而言,仍是一个尚未得到充分探索和解释的指标。这两个特征呈中等程度相关(Pearson 相关系数 = 0.54),表明它们提供了一些互补信息
虚拟生物技术驱动的分析揭示了与临床试验成功相关的基因组特征
最终整合的数据集包含55,984项临床试验,涵盖I期(n=14,237)、II期(n=22,164)、III期(n=14,911)和IV期(n=4,672)(图2B)。试验层面的结果注释与Virtual Biotech提取的靶点层面的分子特征以及来自Open Targets的遗传证据评分相关联。
临床试验研究人员首先成功地复制了Razuvayevskaya等人报告的遗传证据结果,发现遗传支持与试验进展相关,并且还能防止试验早期终止。利用虚拟生物技术中心整理的额外试验结果,研究还发现,达到主要终点且不良事件发生率较低的试验,其遗传证据更为丰富。借鉴类似遗传证据研究的方法,临床试验研究人员随后评估了药物靶点的单细胞转录组特征与试验结果之间的关联。
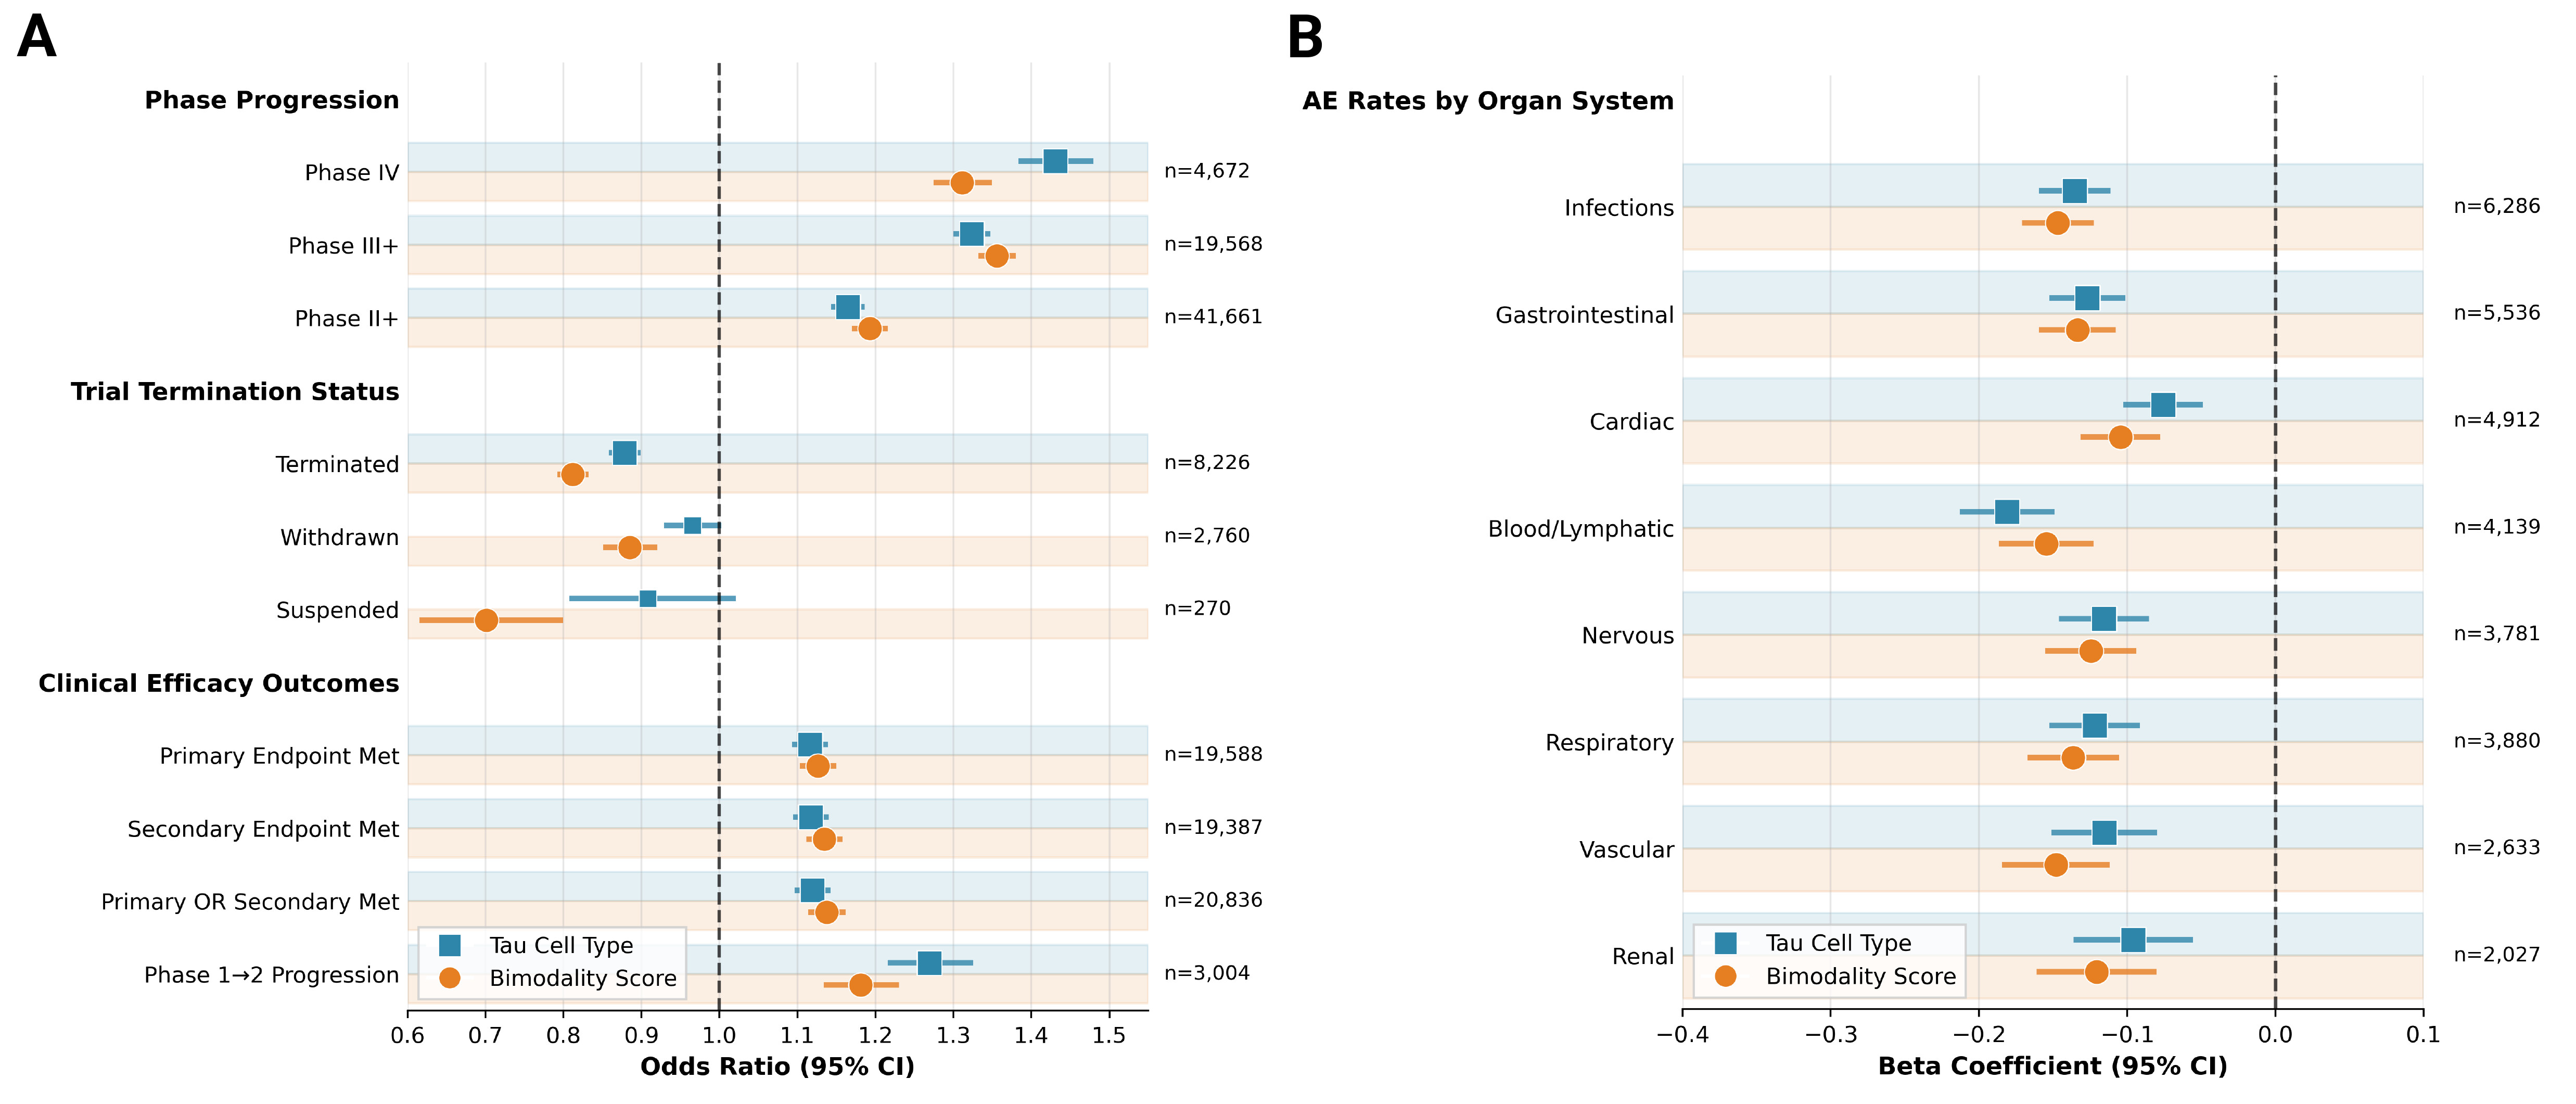
tau细胞类型特异性和表达双峰评分均与临床试验在临床开发阶段的进展相关。根据 tau 指标将靶点二元化为细胞类型特异性与广泛表达类别(详见材料和方法),临床试验人员发现,作用于细胞类型特异性靶点的药物进入 IV 期的可能性高出 48% figure3A。
 {fig-alt=“figure3”, fig-align=“center”}